Embedding-basierte vierklassige Landbedeckungskartierung
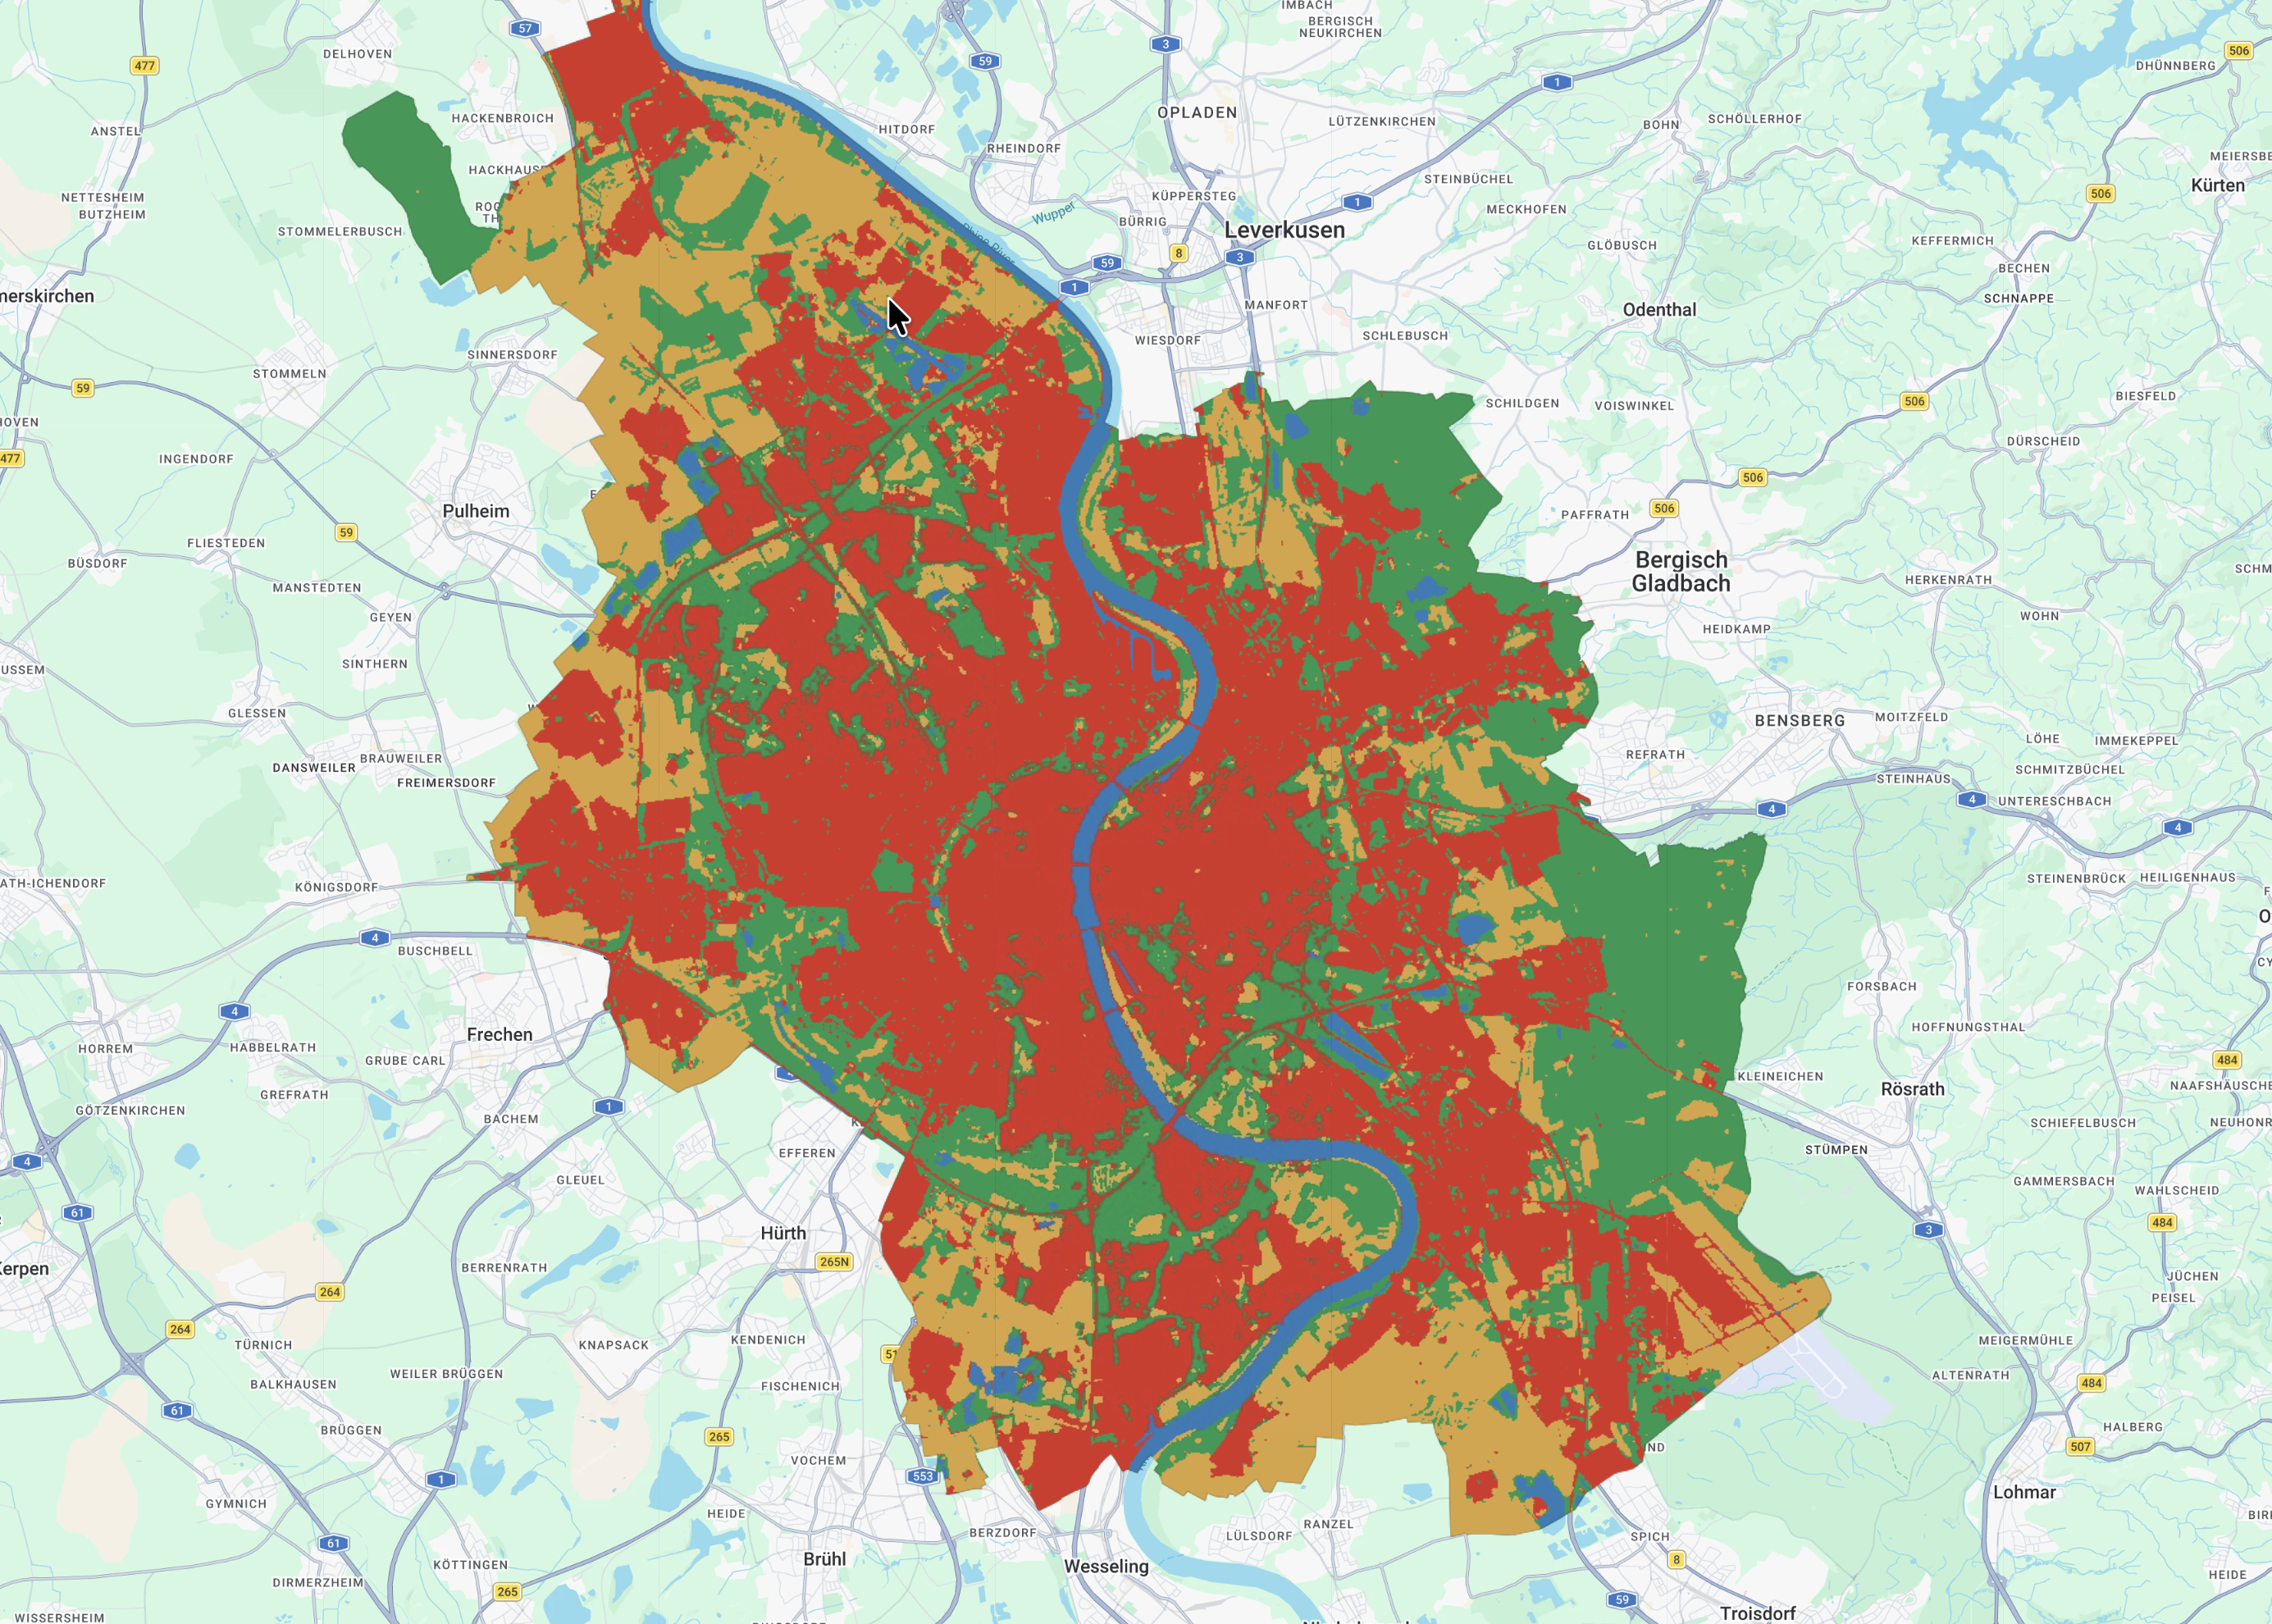
Dieses Projekt untersucht einen modernen Workflow zur Landbedeckungsklassifikation mit Google Satellite Embeddings als vortrainierten georäumlichen Features. Ein K-Nearest-Neighbors-Klassifikator unterscheidet Siedlung / versiegelte Fläche, offenes Land, Wasser und Vegetation in Köln.
Daten und gelernte Features
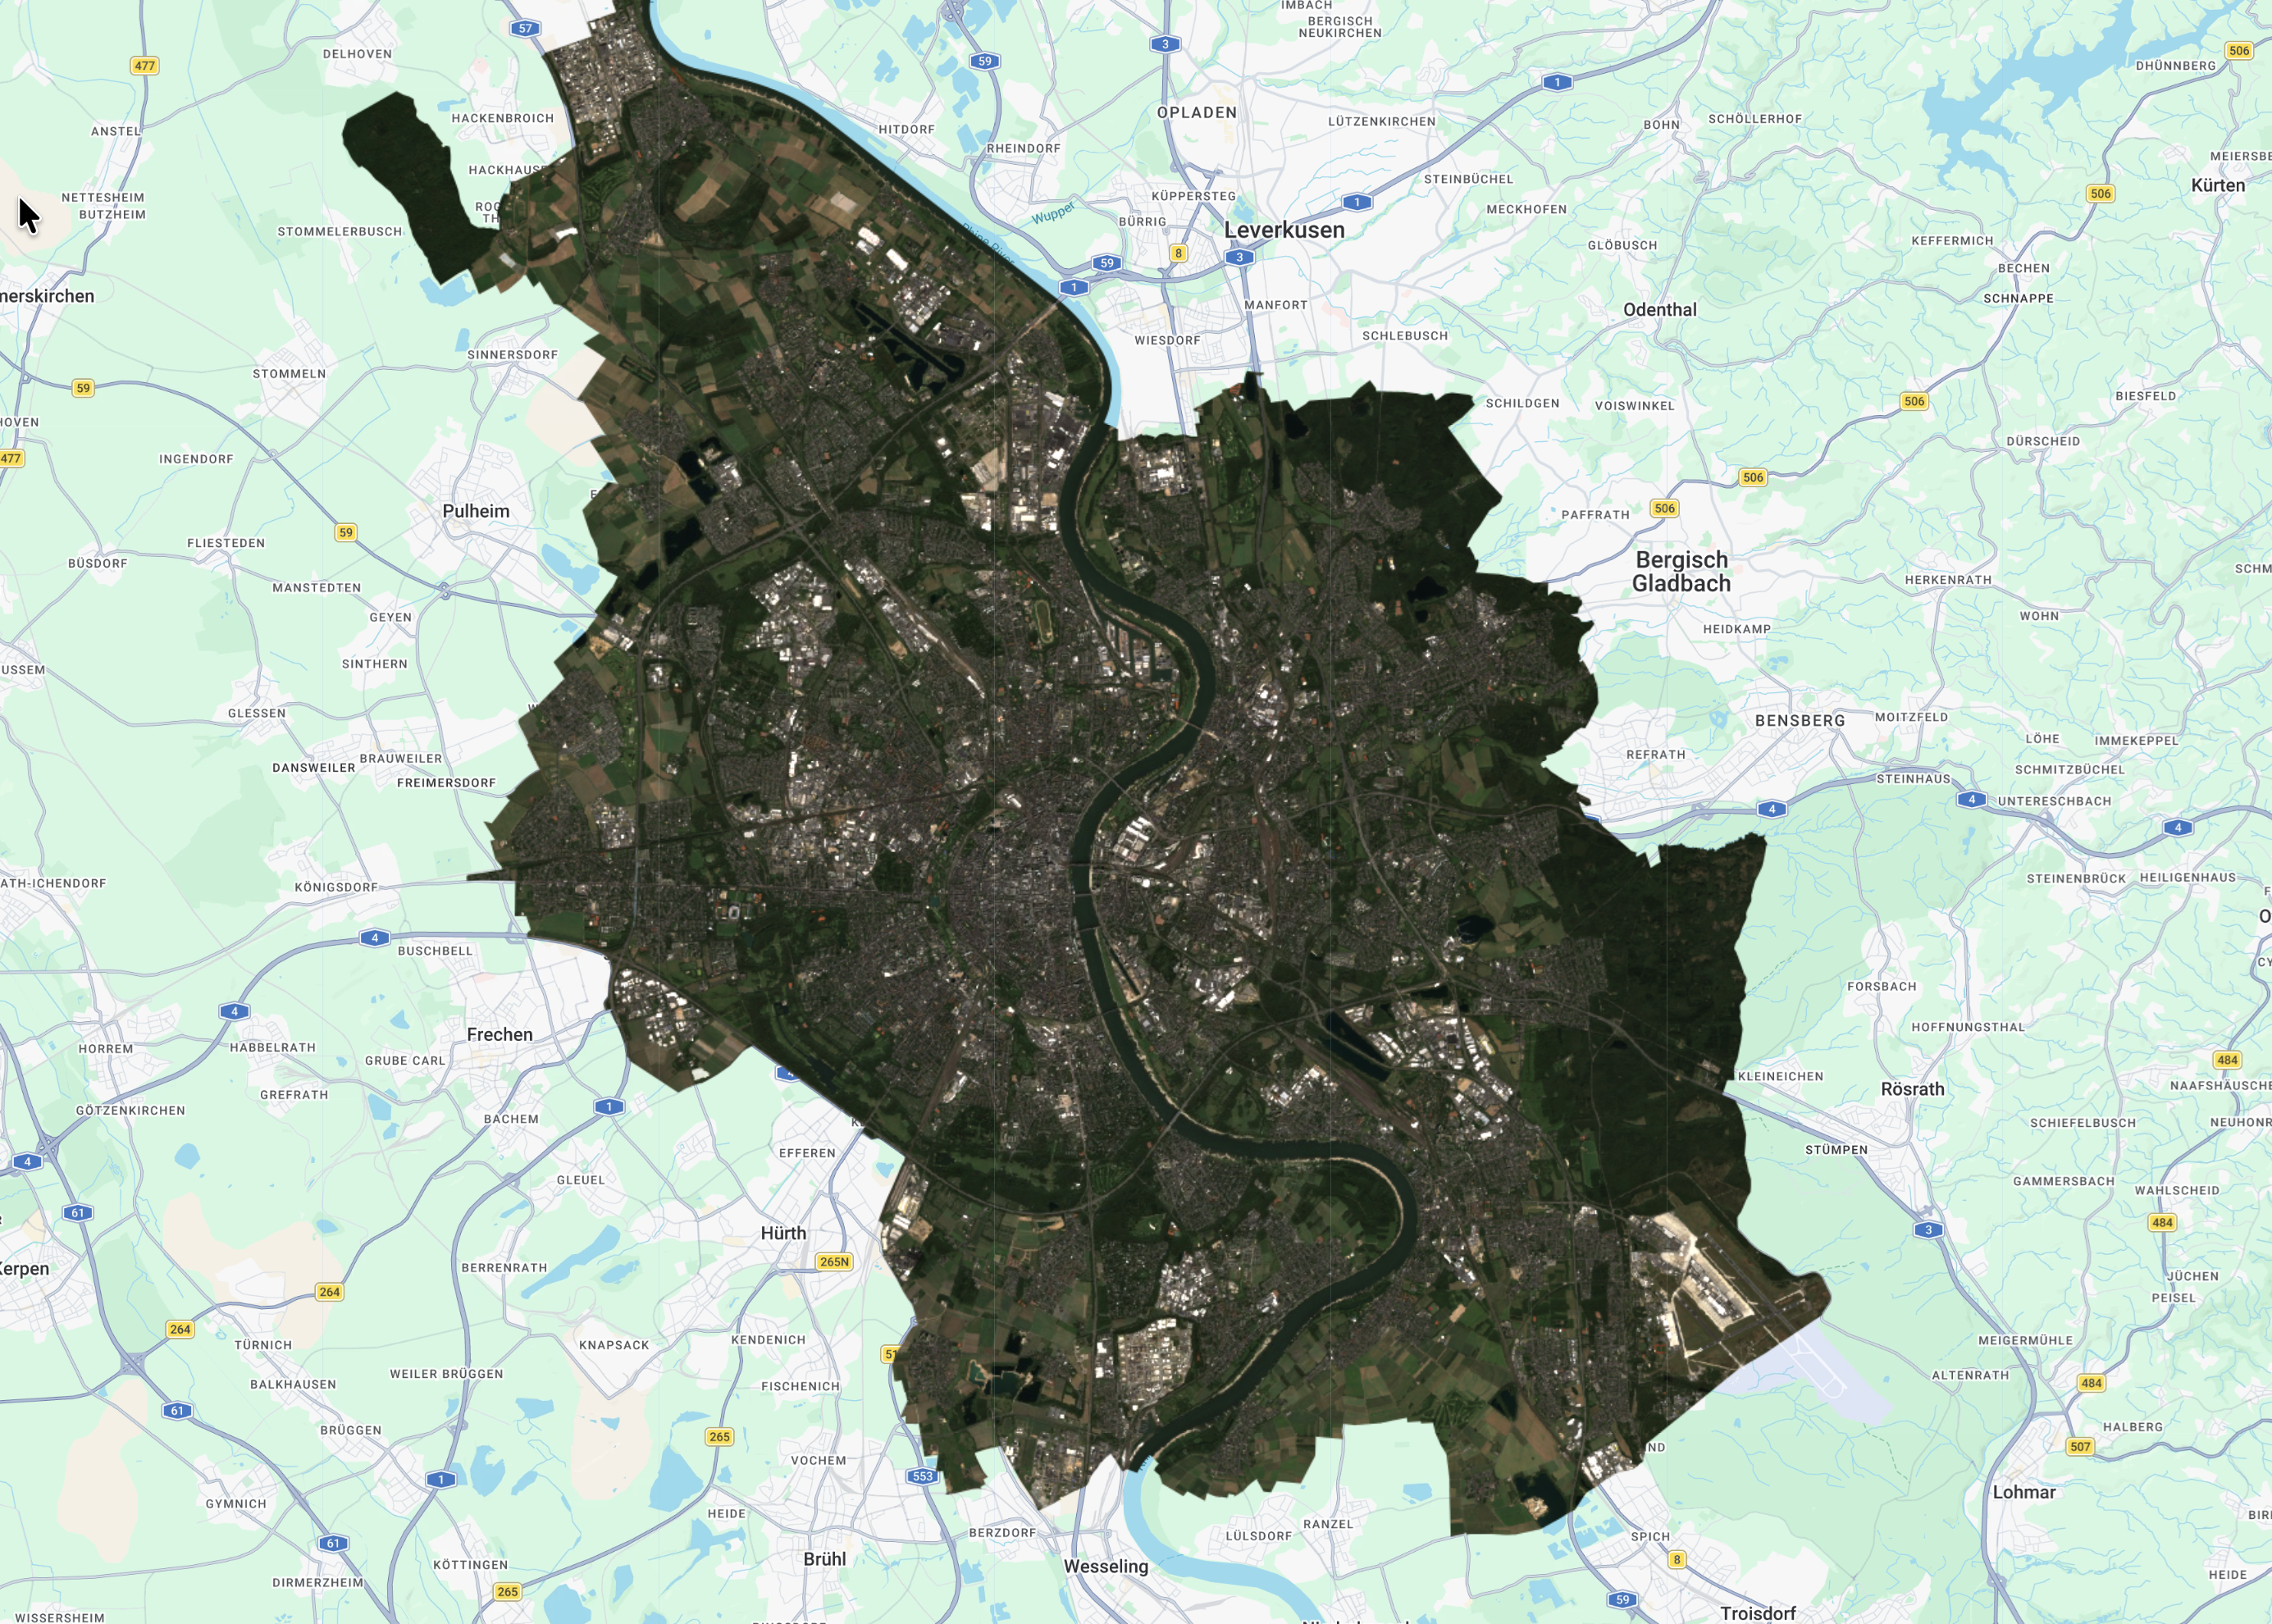
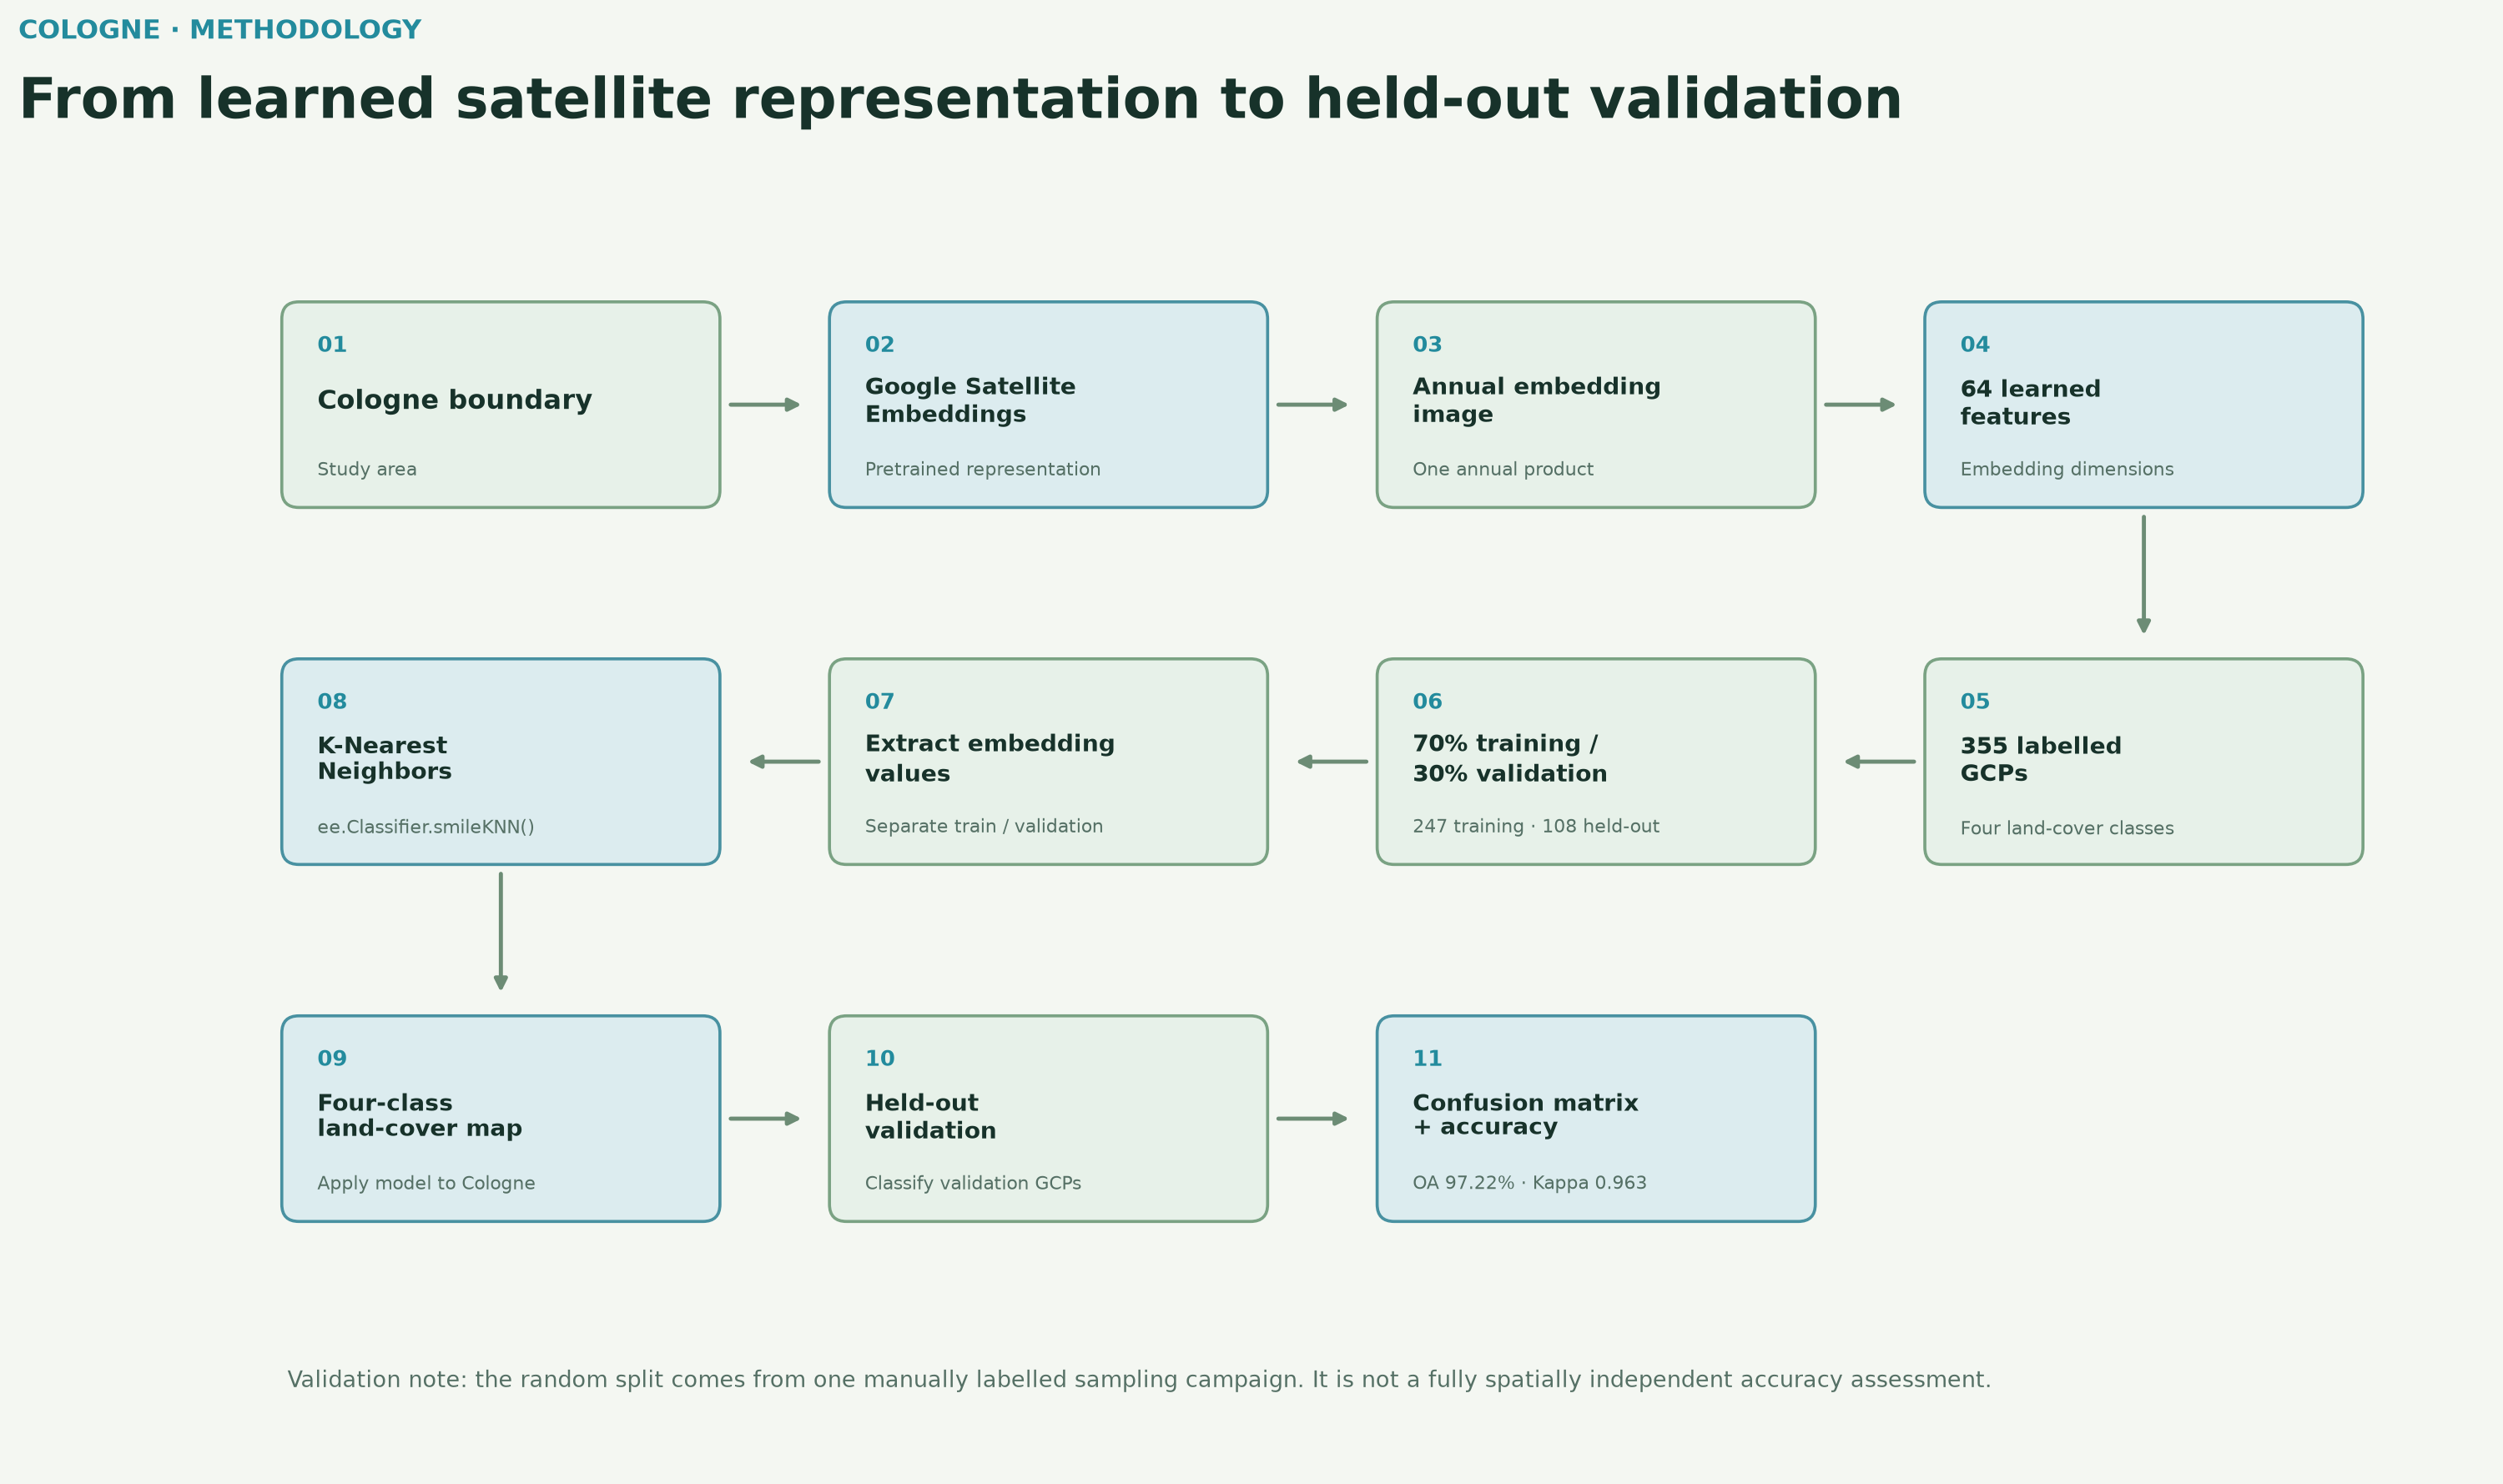
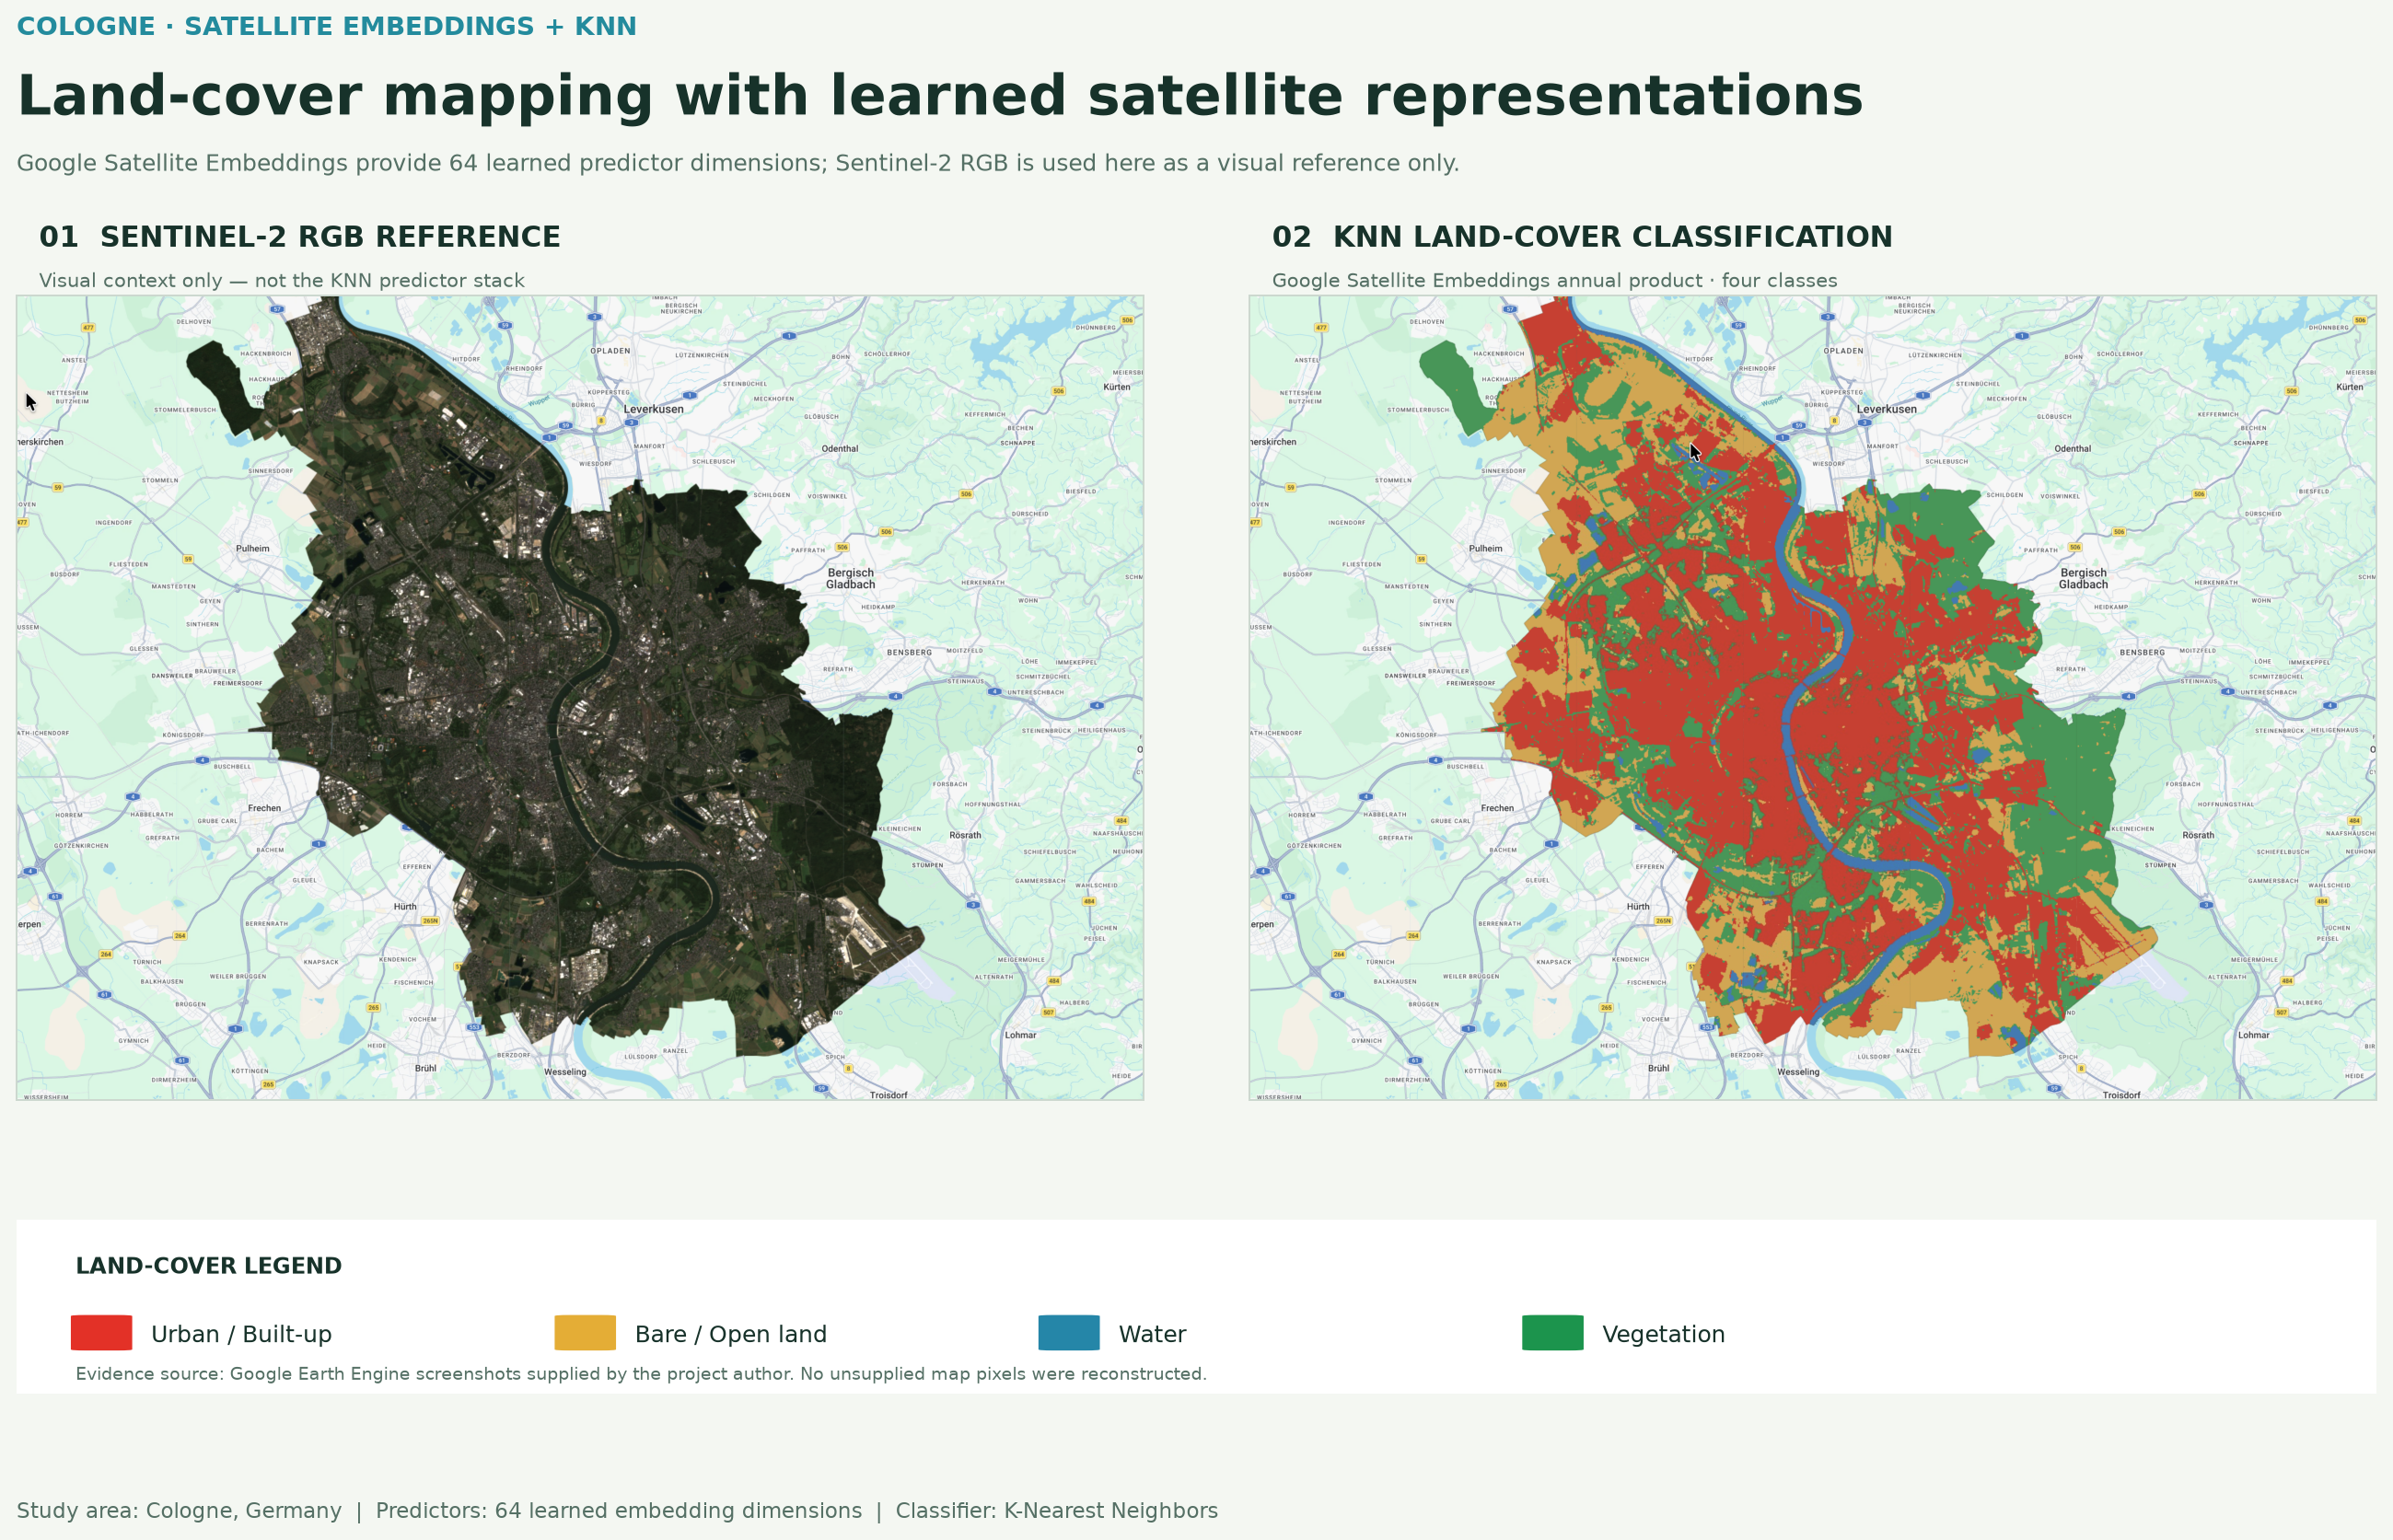
Ein jährliches Bild aus dem Jahr 2025 aus GOOGLE/SATELLITE_EMBEDDING/V1/ANNUAL liefert 64 gelernte Embedding-Dimensionen für den Klassifikator. Sentinel-2-RGB dient ausschließlich als visuelle Referenz; es ist nicht der direkte KNN-Prädiktor-Stack.
Trainings- und Validierungsdaten
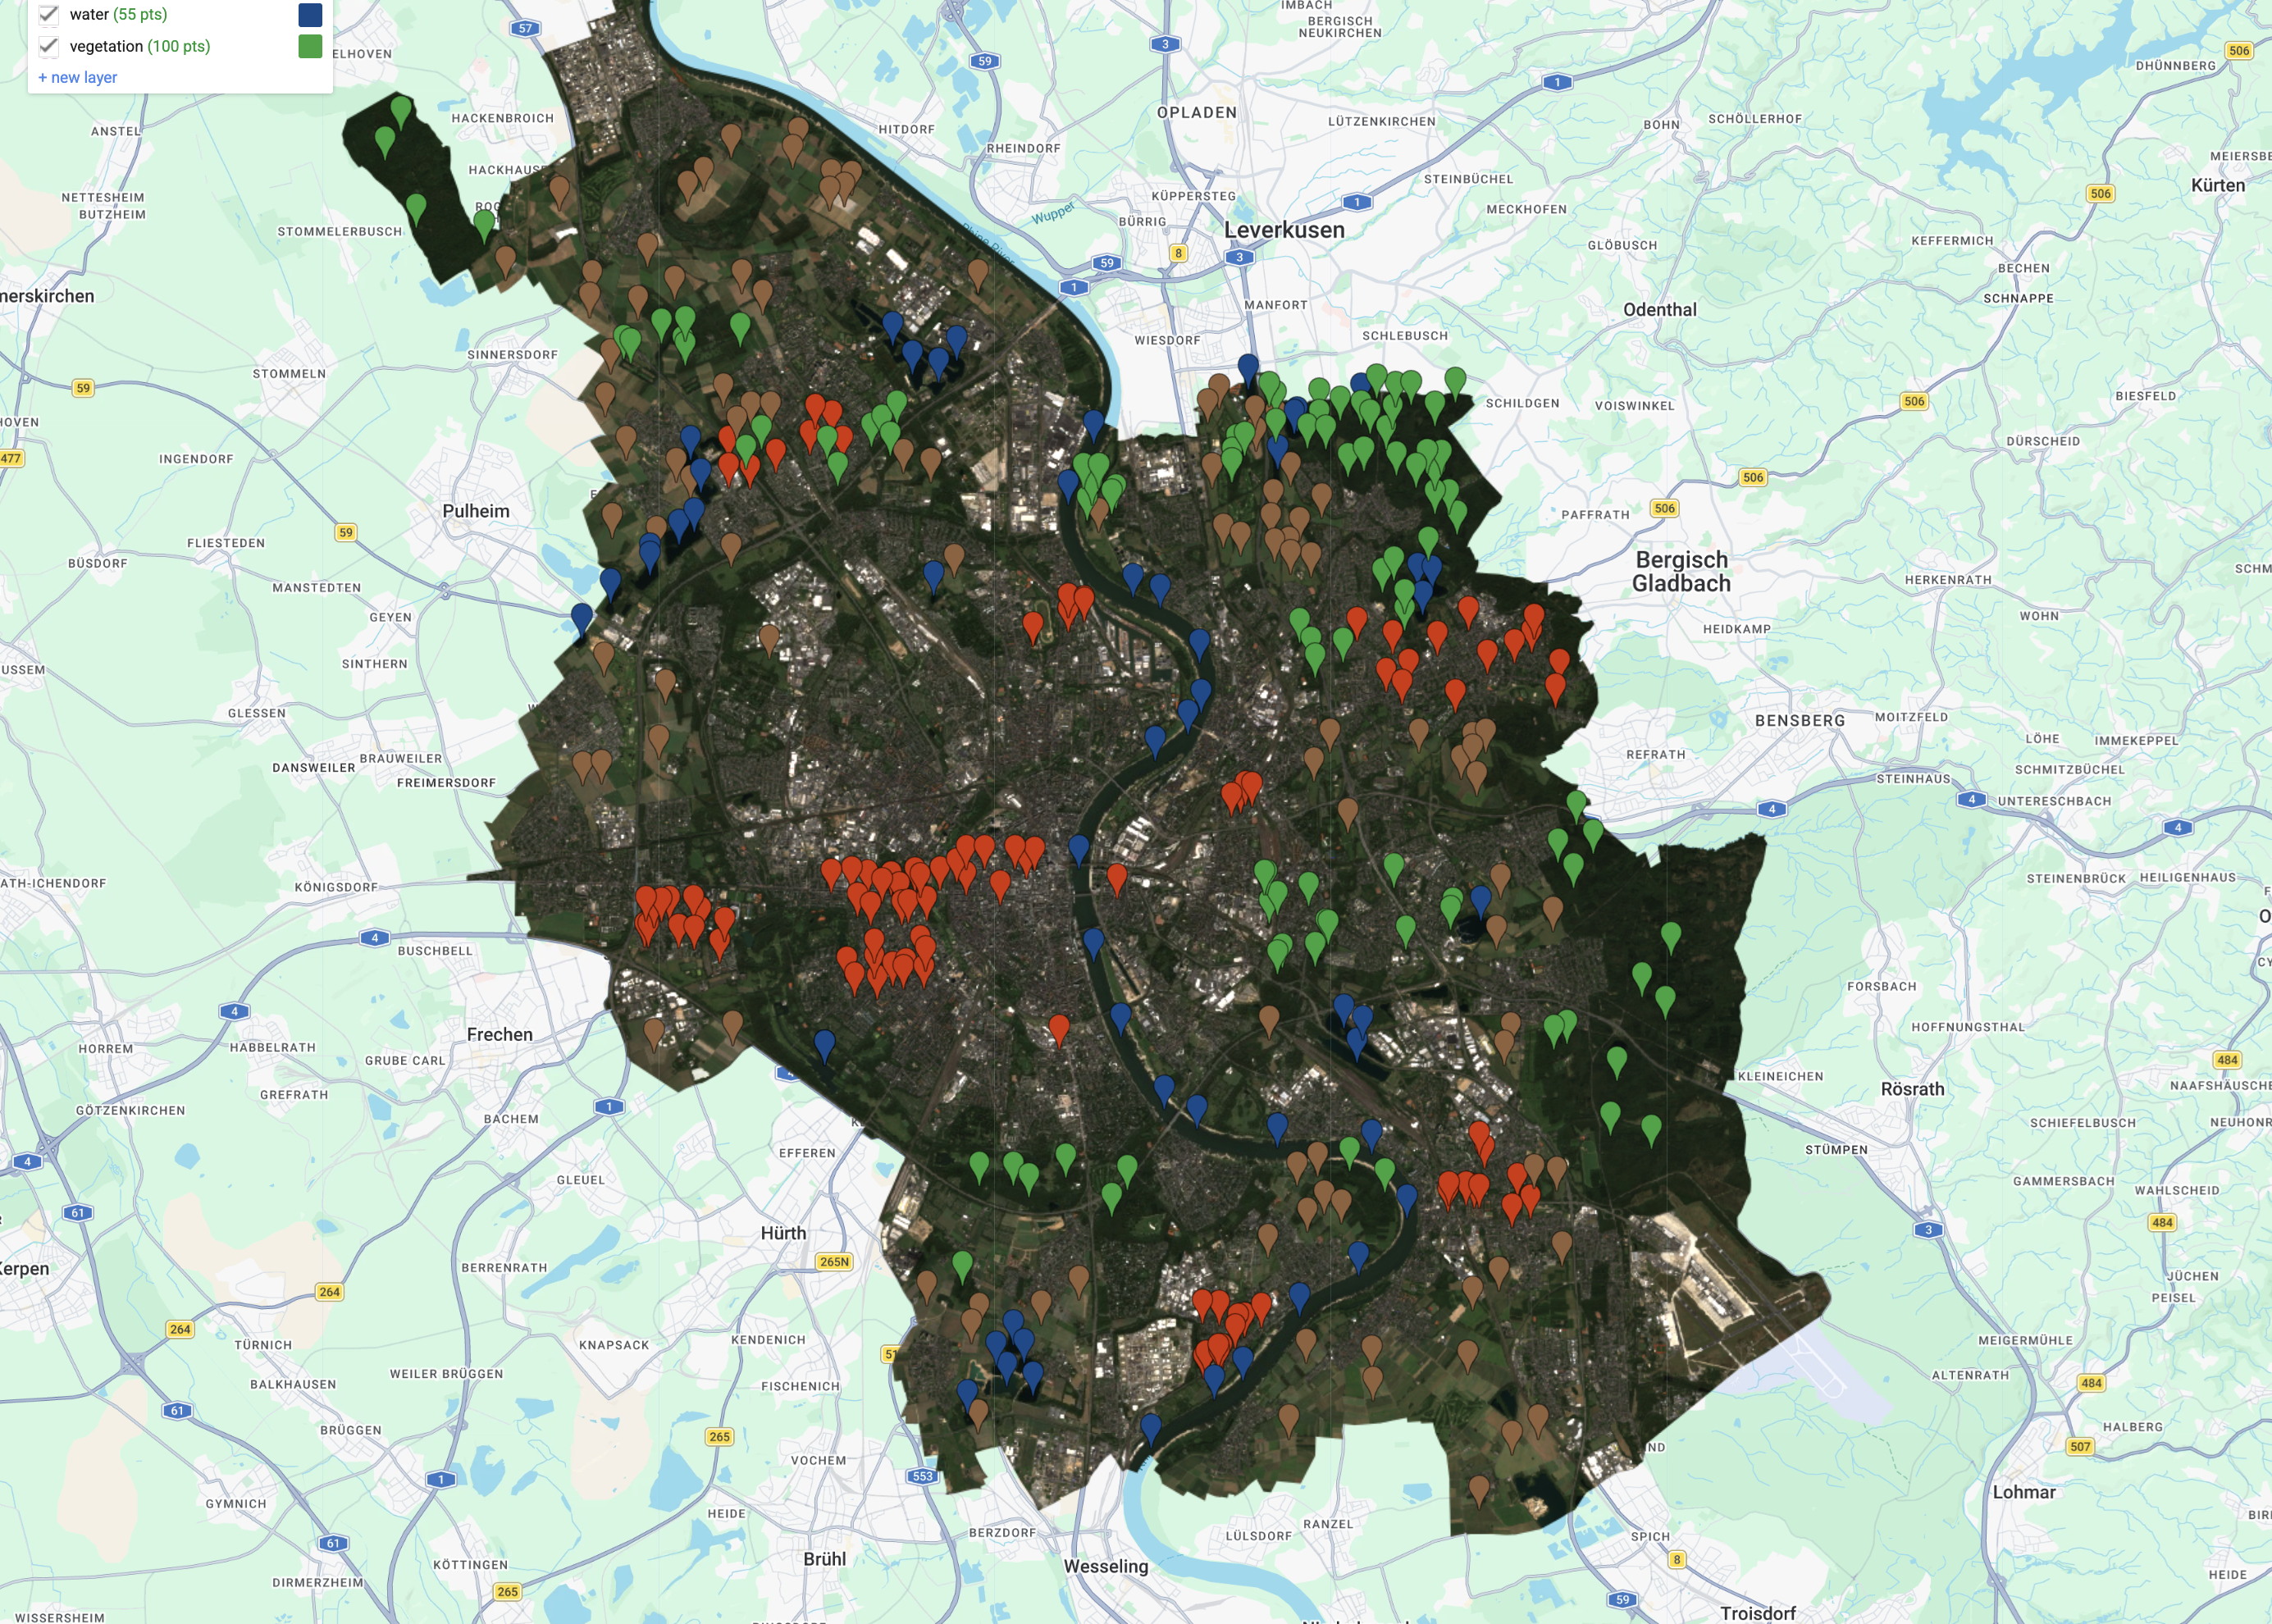
Die vier manuell gelabelten Klassen wurden durch 355 ursprüngliche Referenzpunkte abgedeckt. Eine reproduzierbare zufällige 70% / 30%-Aufteilung mit Seed 42 ergab 247 Trainings-GCPs und 108 zurückgehaltene Validierungs-GCPs, bevor die Embedding-Werte extrahiert wurden.
Methode
Embedding-Werte wurden getrennt für Trainings- und Validierungsstandorte extrahiert. Der Klassifikator wurde mit ee.Classifier.smileKNN() und den Earth-Engine-Standardwerten implementiert; zusätzliche KNN-Hyperparameter wurden nicht explizit konfiguriert. Der trainierte Klassifikator wurde auf das Kölner Untersuchungsgebiet angewendet und mit der zurückgehaltenen zufälligen Validierungsstichprobe bewertet.
RGB-Referenz und KNN-Karte
Der Kartenvergleich stellt die Sentinel-2-RGB-Referenz der finalen vierklassigen KNN-Karte gegenüber. Die Bilder sind saubere Ausschnitte aus den bereitgestellten Google-Earth-Engine-Ausgaben; Rasterinhalte wurden nicht rekonstruiert.
Genauigkeitsbewertung
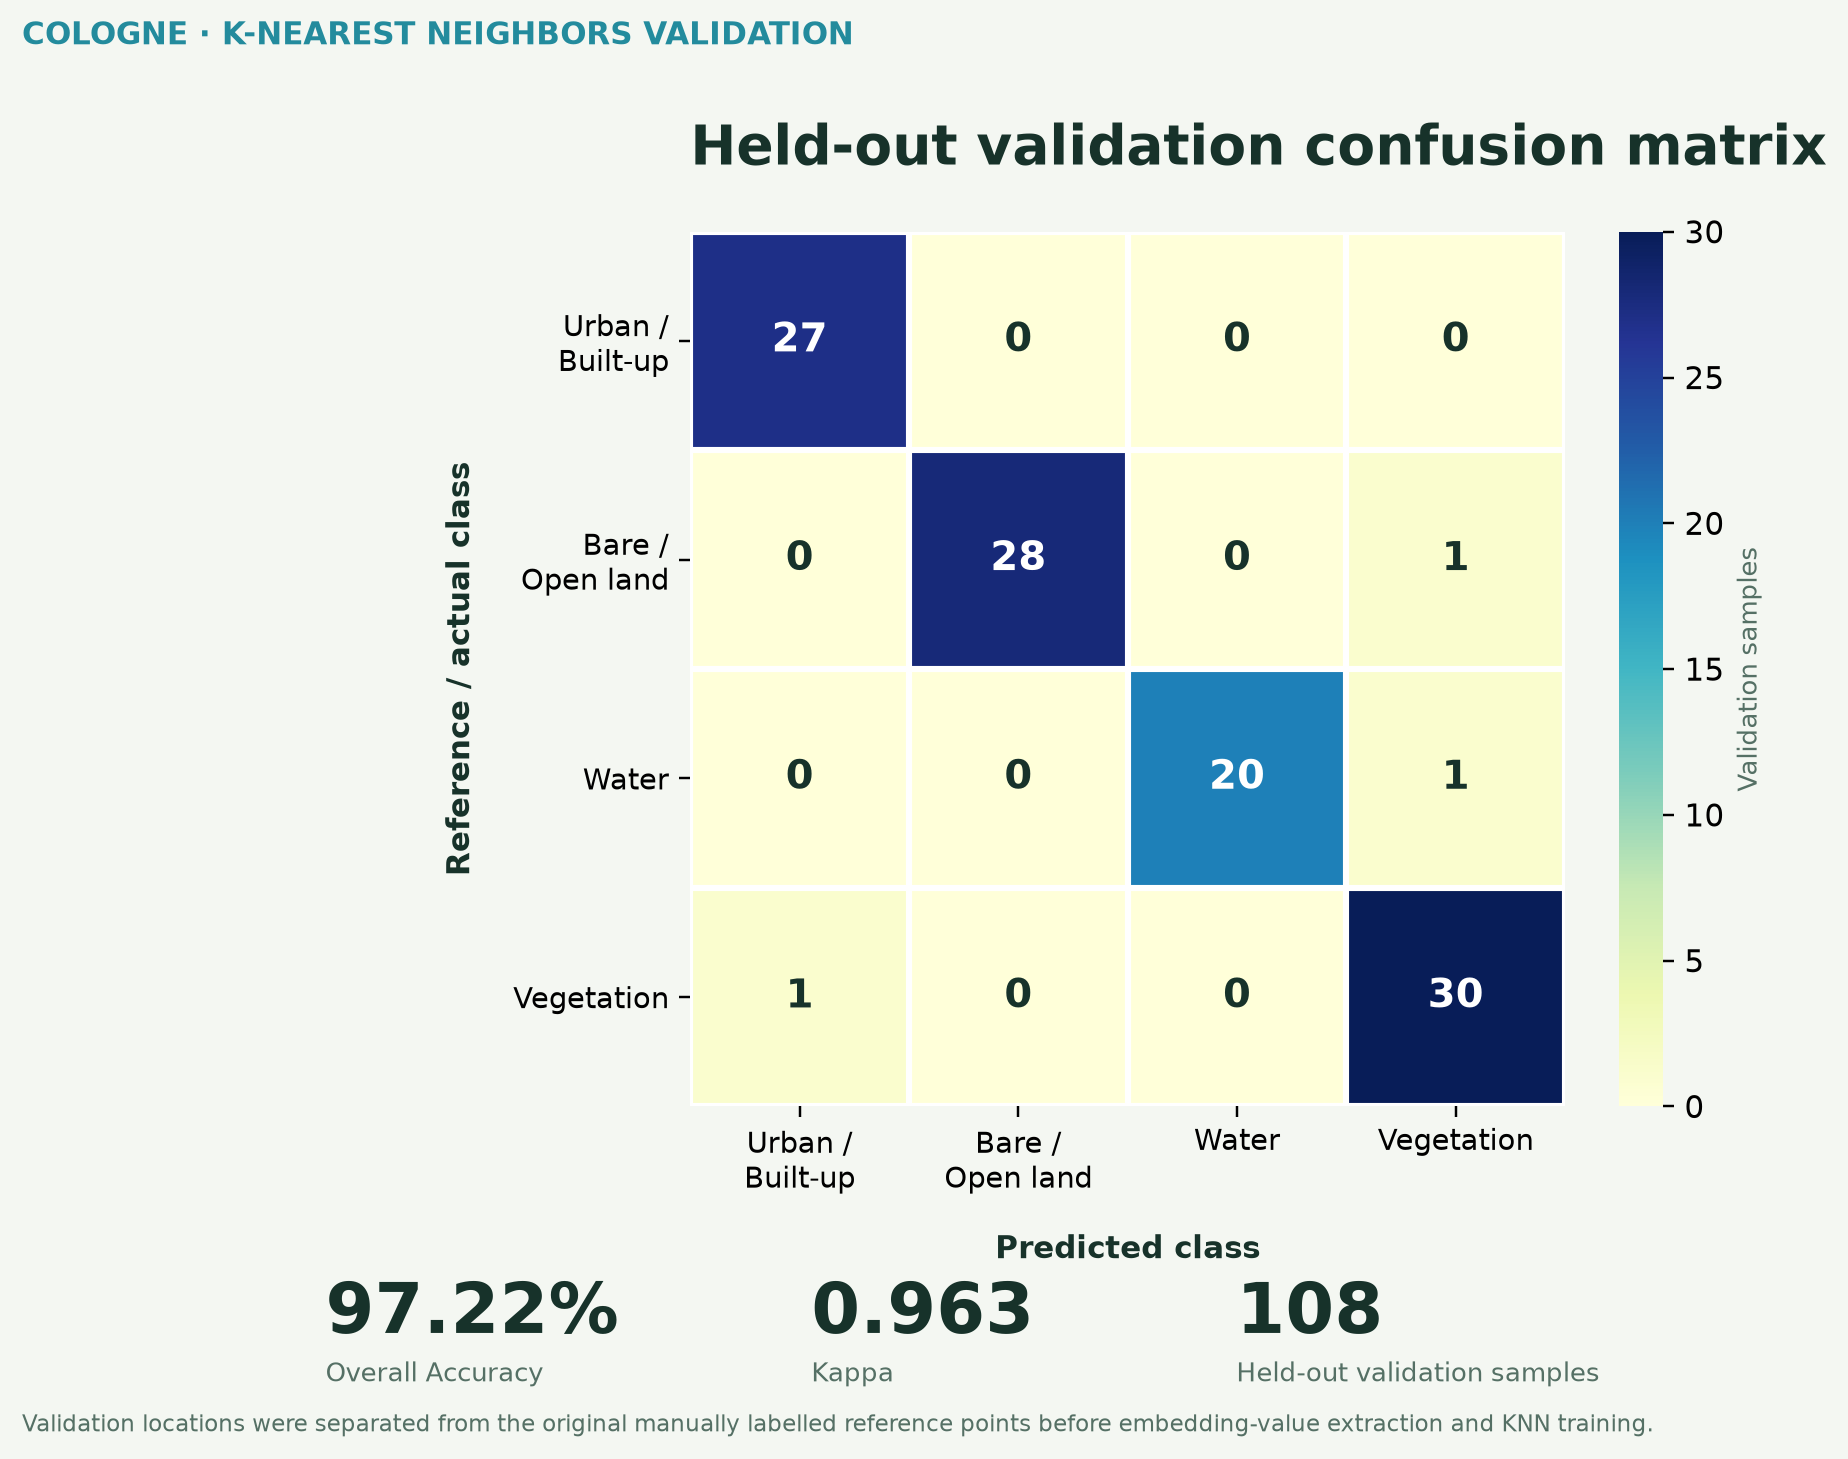
| Klasse | Producer Accuracy | User Accuracy |
|---|---|---|
| Siedlung / versiegelt | 100,0% | 96,4% |
| Offenes Land | 96,6% | 100,0% |
| Wasser | 95,2% | 100,0% |
| Vegetation | 96,8% | 93,8% |
Producer Accuracy beschreibt, wie gut tatsächliche Referenzpunkte einer Klasse erfasst wurden; User Accuracy beschreibt die Zuverlässigkeit einer vorhergesagten Klasse.
Klassifizierte Landbedeckungsfläche
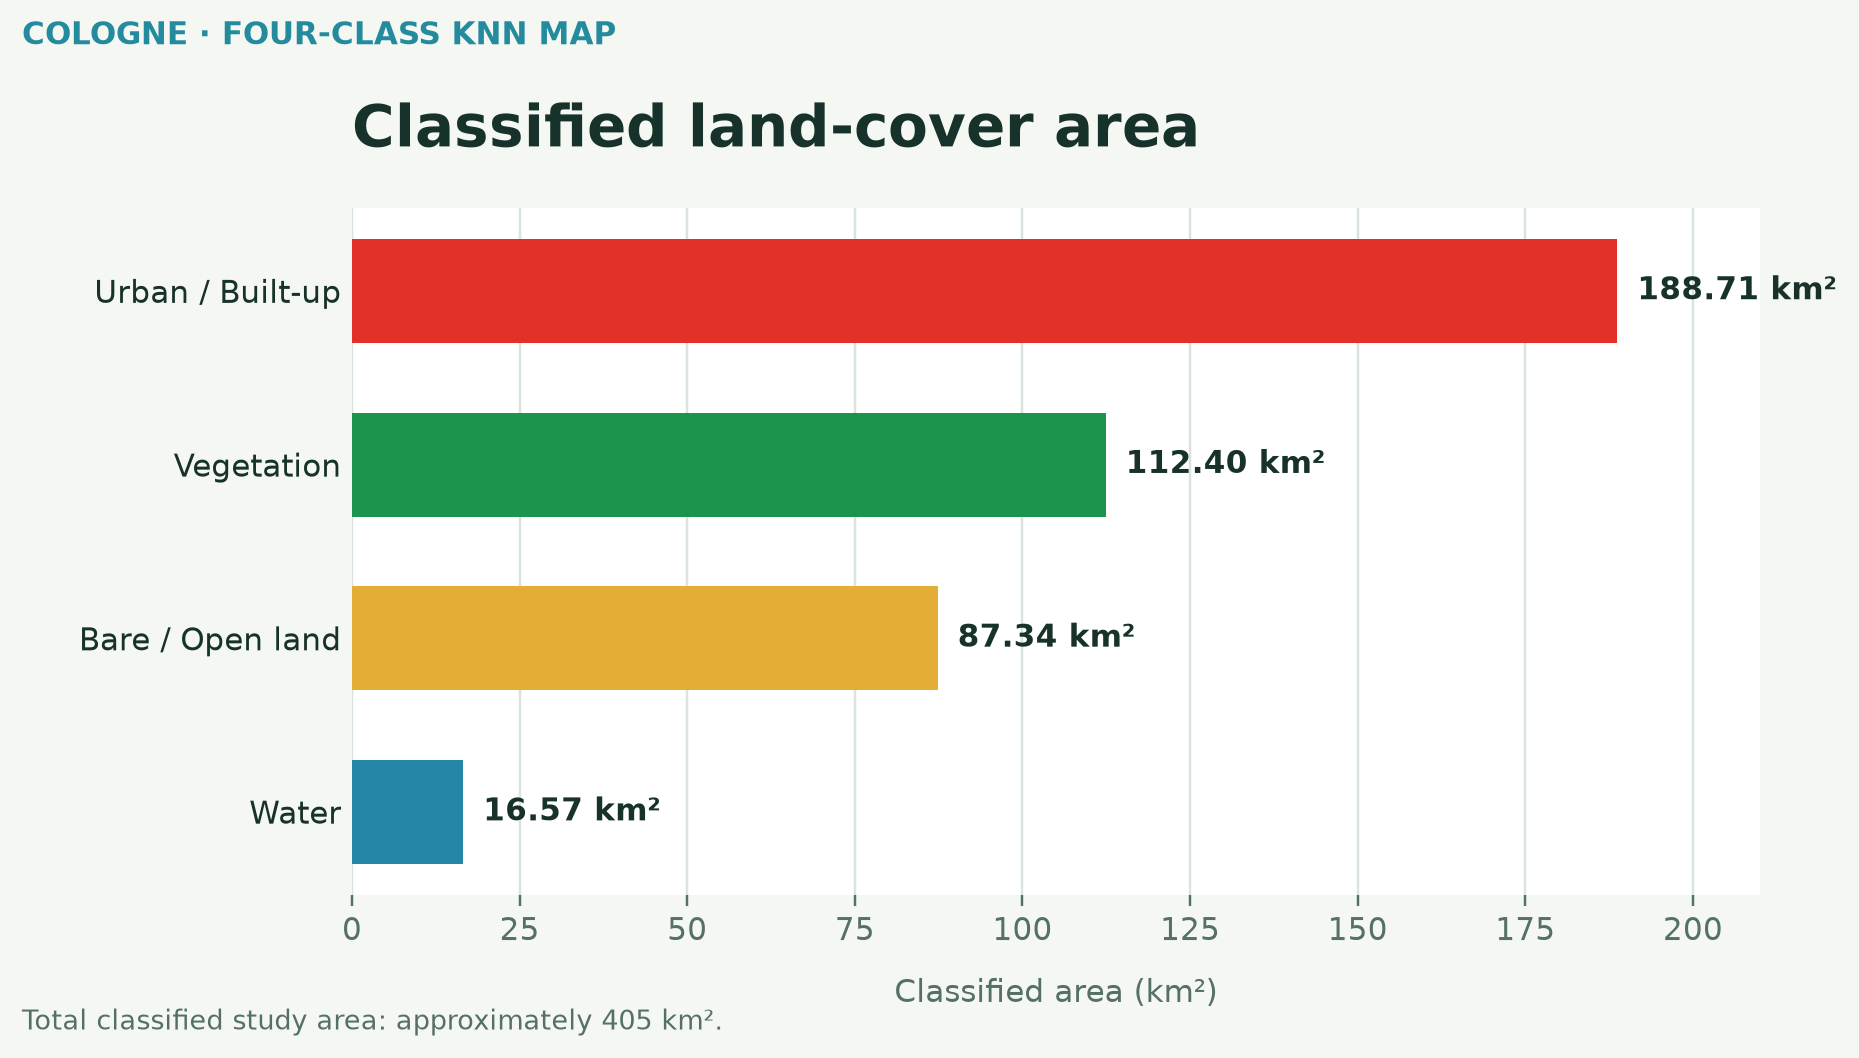
Die vier Klassen umfassen etwa 405 km² des klassifizierten Untersuchungsgebiets. Dies sind kartenbasierte Klassensummen und keine unabhängigen Referenzmessungen.
Warum Embeddings interessant sind
Traditionelle Workflows verwenden rohe Spektralbänder und manuell entwickelte Indizes für einen Klassifikator. Hier wird jeder Standort durch ein 64-dimensionales gelerntes Satellite Embedding aus Googles vorab berechnetem jährlichen Embedding-Produkt repräsentiert; KNN arbeitet direkt auf dieser Feature-Repräsentation. Die Embedding-Dimensionen werden dabei nicht als einzelne Spektralbänder behandelt.
Das Embedding-basierte KNN-Modell erreicht eine starke Klassentrennung in dieser Holdout-Stichprobe: Alle Siedlungs-Referenzpunkte wurden korrekt erkannt; die verbleibenden Fehler betreffen je einen Punkt für offenes Land und Wasser, der als Vegetation klassifiziert wurde, sowie einen Vegetationspunkt, der als Siedlung klassifiziert wurde.
Einordnung und Werkzeuge
Die Validierungspunkte stammen aus derselben manuell gelabelten Stichprobenkampagne wie die Trainingspunkte und wurden zufällig statt räumlich unabhängig geteilt. Die hohe Validierungsgenauigkeit ist daher keine garantierte kartenweite Genauigkeit. Die KNN-Leistung kann zudem von Nachbarschaftseinstellungen und der Struktur des Feature-Raums abhängen. Das Projekt ist eine Portfolio- und Forschungsdemonstration, kein autoritativer Landbedeckungsdatensatz.
Google Earth Engine · Google Satellite Embeddings · K-Nearest Neighbors · Sentinel-2-RGB-Referenz · JavaScript · Python · Matplotlib
Lernattribution: Methodisch orientiert sich das Projekt am Spatial-Thoughts-Kurs „End-to-End Google Earth Engine“ von Ujaval Gandhi.